EKS Networking
Week 2 학습 주제: Amazon EKS의 네트워킹 구조를 깊이 이해하고, VPC CNI, Service, LoadBalancer, Ingress, ExternalDNS 등 네트워크 관련 핵심 기능을 학습한다.
AWS VPC CNI 소개
1. VPC CNI
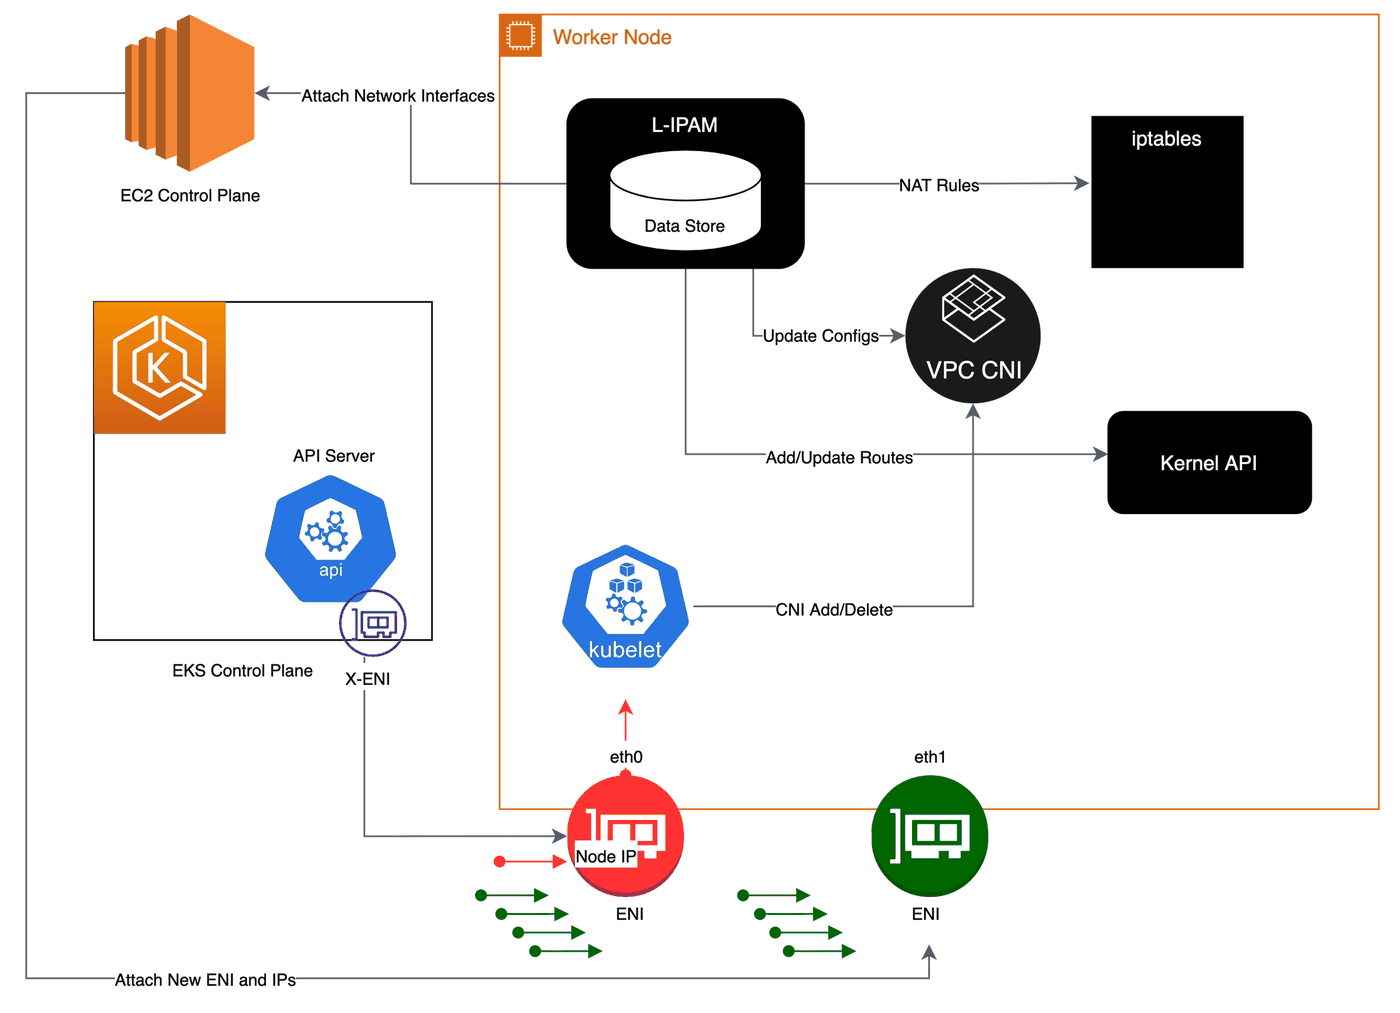
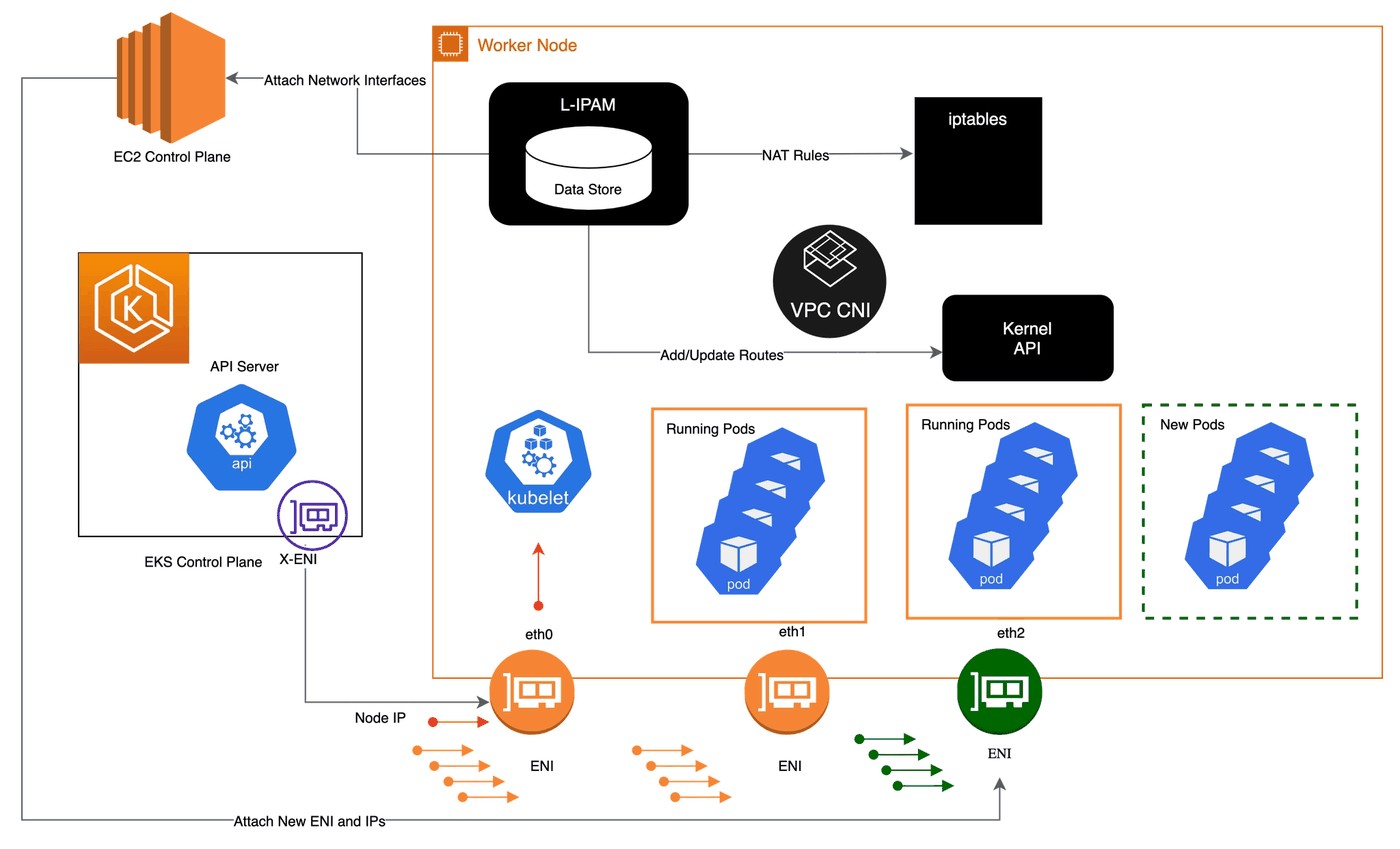
aws-node가 두 역할로 나뉜다는 점이 핵심이다. L-IPAM은 EC2 컨트롤 플레인에 ENI와 IP 할당을 요청하고, CNI 바이너리는 커널 API만 건드린다. 노드 자신의 IP는 eth0에 있고 eth1의 초록색 IP들은 오직 파드용으로 예약된다. 즉 ENI 부착은 쿠버네티스가 아니라 EC2 API 작업이다.
AWS VPC CNI는 EKS에서 기본으로 사용하는 Container Network Interface 플러그인이다.
- Pod에 VPC IP 주소를 직접 할당
- AWS Security Group for Pods 지원
- Overlay Network 없이 Native VPC 라우팅
- Secondary IP 또는 Prefix Delegation 모드 지원
graph TB
    subgraph "Worker Node"
        A[kubelet] --> B[VPC CNI Plugin]
        B --> C[aws-k8s-agent]
        C --> D[EC2 ENI]

        subgraph "Pod Network Namespace"
            E[eth0 - Pod1]
            F[eth0 - Pod2]
        end

        D --> G[veth pair]
        G --> E
        G --> F
    end

    D --> H[VPC Subnet]
    H --> I[AWS Network]
- Native 성능: Overlay Network Overhead 없음
- AWS 통합: Security Group, NACLmichael 직접 적용
- 간편한 관리: VPC Flow Logs로 Pod 트래픽 모니터링
- 보안: Pod별 Security Group 적용 가능
2. CNI Plugin 동작 원리
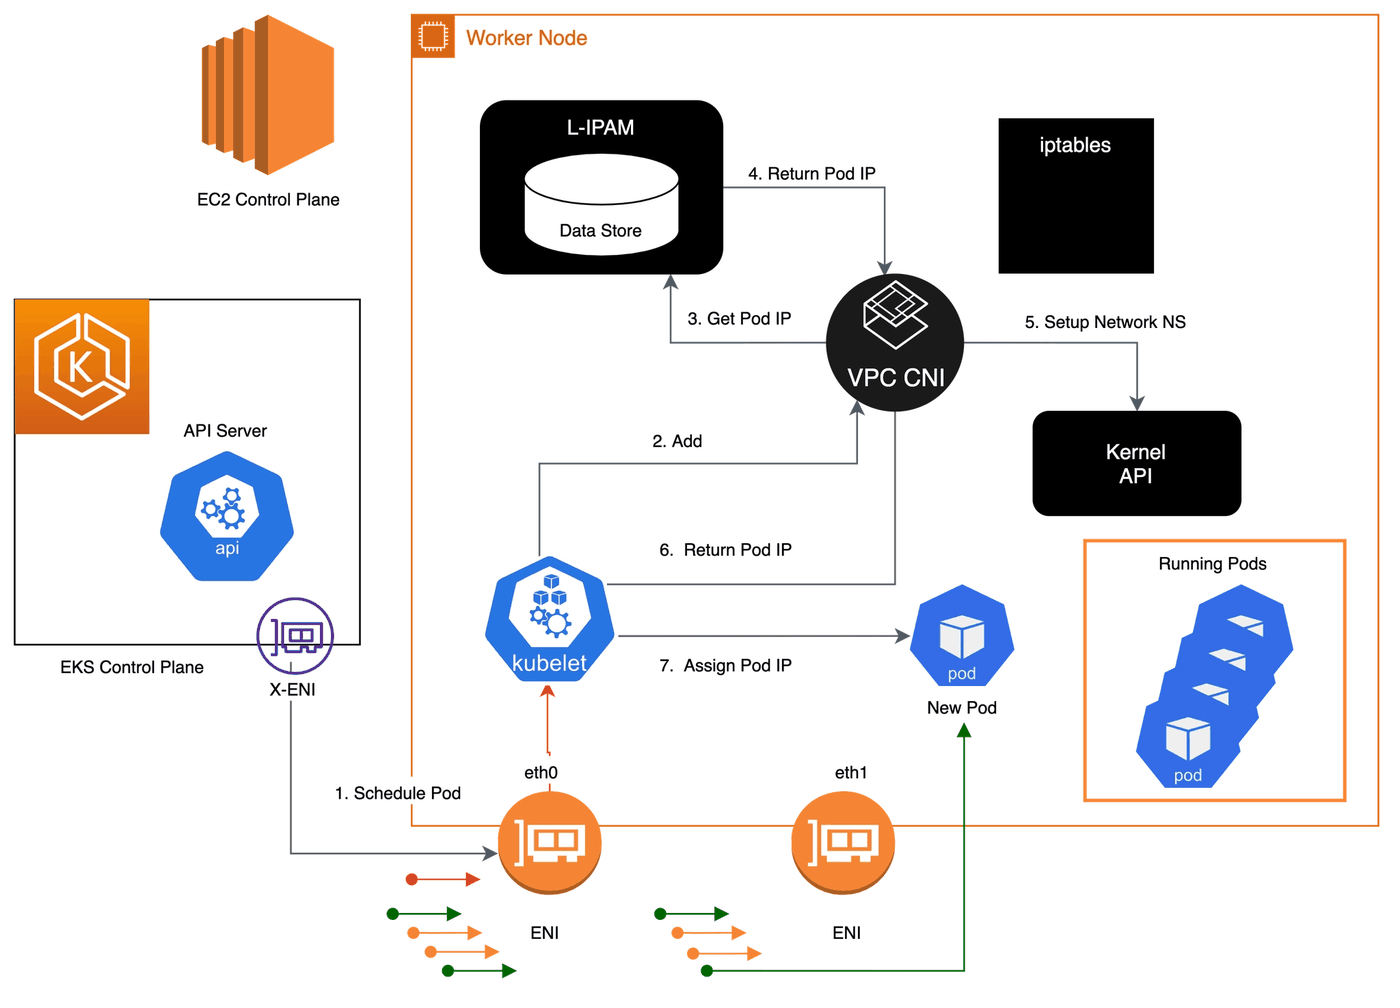
3~4단계에서 IP가 로컬 L-IPAM 워밍풀에서 먼저 나오고, 네트워크 네임스페이스 설정(5단계)은 그 뒤라는 순서가 중요하다. 파드 스케줄링이 EC2 API 호출을 기다리지 않는다는 뜻이며, 그래서 워밍풀 설정이 파드 기동 지연을 좌우한다.
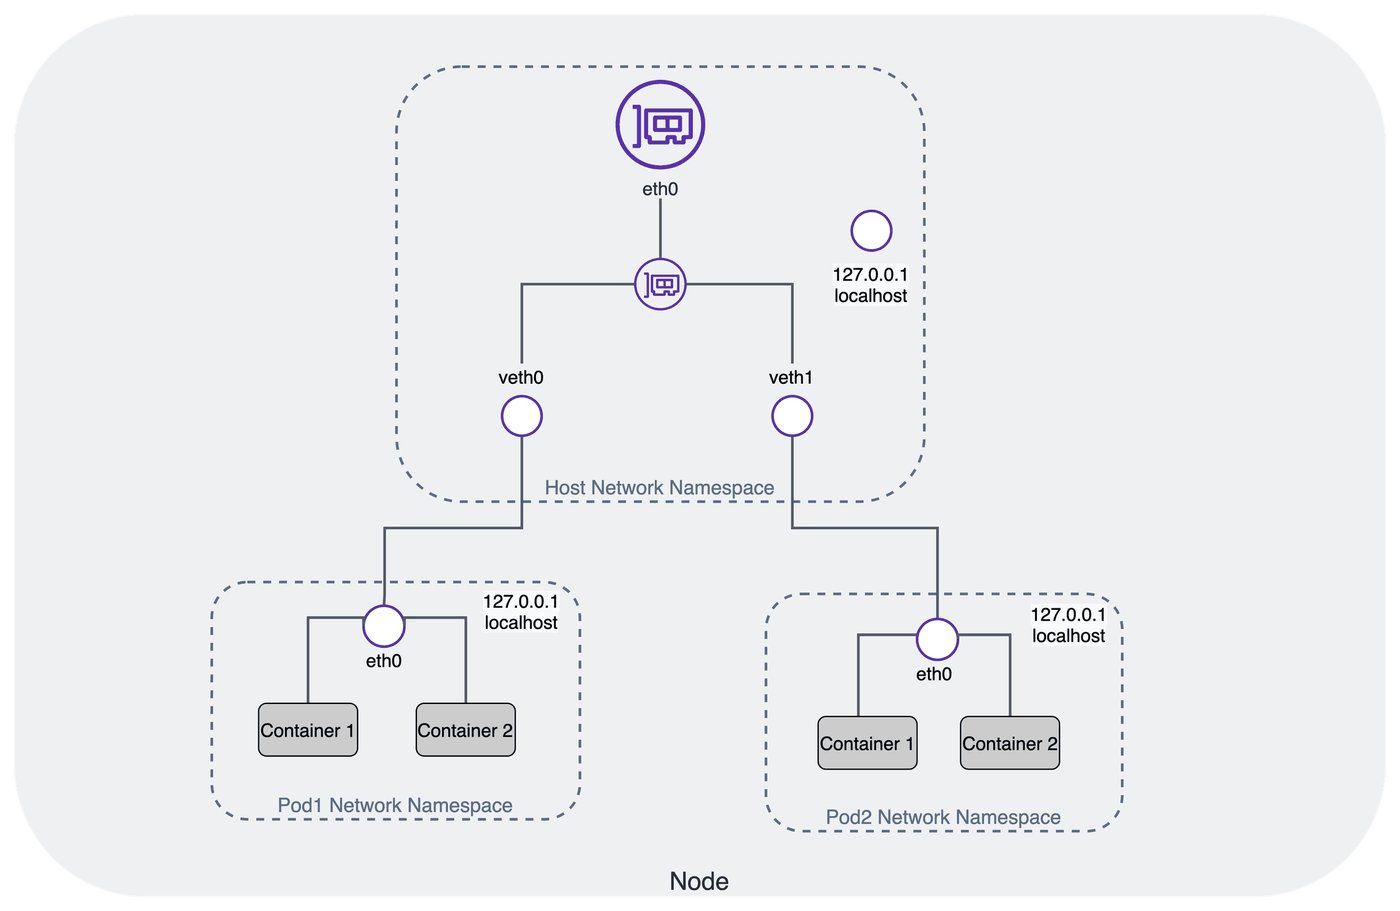
각 파드 네임스페이스가 자기만의 127.0.0.1을 갖는다 — 노드 하나에 localhost가 셋이다. 같은 파드 안 컨테이너끼리는 localhost로 통신되지만 다른 파드끼리는 안 되는 이유가 이 그림에 그대로 있다.
CNI Plugin 호출 시점:
- Pod 생성 시: ADD 명령어
- Pod 삭제 시: DEL 명령어
sequenceDiagram
    participant K as kubelet
    participant C as VPC CNI
    participant L as L-IPAM
    participant E as EC2 API
    participant V as VPC

    K->>C: ADD (Pod 생성)
    C->>L: IP 주소 요청
    L->>E: DescribeNetworkInterfaces
    alt IP 주소 풀에 여유 있음
        L-->>C: 사용 가능한 IP 반환
    else IP 주소 부족
        L->>E: AttachNetworkInterface (새 ENI)
        L->>E: AssignPrivateIpAddresses
        E->>V: Secondary IP 할당
        V-->>E: IP 할당 완료
        E-->>L: IP 주소 반환
        L-->>C: 새로 할당된 IP 반환
    end

    C->>K: Pod IP 반환
    K->>K: Setup Network Namespace
    K->>K: Configure Routes
3. IP 주소 할당 모드
Amazon VPC CNI는 두 가지 IP 할당 모드를 지원한다.
(1) Secondary IP mode (기본값)
특징:
- ENI에 연결된 각 Secondary Private IP 주소를 Pod에 개별 할당
- IP 주소 범위: /16 CIDR (65,536개)
graph TB
    subgraph "Secondary IP Mode"
        subgraph "Worker Subnet: 10.0.0.0/16"
            A[Instance: 10.0.1.101]
            B[Instance: 10.0.0.203]
            C[Instance: 10.0.2.123]
        end

        subgraph "Primary ENI"
            A --> D["Primary IP: 10.0.0.20<br/>Secondary IPs:<br/>slot2: 10.0.0.101<br/>slot3: 10.0.0.203<br/>slot4: 10.0.2.123"]
        end

        subgraph "Secondary ENI"
            A --> E["Primary IP: 10.0.0.30<br/>Secondary IPs:<br/>slot2: 10.0.1.64<br/>slot3: 10.0.0.32<br/>slot4: 10.0.2.67"]
        end
    end

    D --> F[Pod1: 10.0.0.101]
    D --> G[Pod2: 10.0.0.203]
    E --> H[Pod3: 10.0.1.64]
(2) Prefix Delegation mode
특징:
- IP 주소를 개별이 아닌 /28 Prefix 단위로 할당
- IP 주소 범위: /28 블록 (16개 IP)
- 더 많은 Pod를 배치 가능
graph TB
    subgraph "Prefix Delegation Mode"
        subgraph "Worker Subnet: 10.0.0.0/16"
            A[Instance]
        end

        subgraph "Primary ENI"
            A --> B["Primary IP: 10.0.0.20<br/><br/>Prefix Delegations:<br/>192.168.2.16/28 (16 IPs)<br/>192.168.2.32/28 (16 IPs)<br/>192.168.2.112/28 (16 IPs)"]
        end
    end

    B --> C[Pod1: 192.168.2.16]
    B --> D[Pod2: 192.168.2.17]
    B --> E[Pod3: 192.168.2.18]
    B --> F[...]
    B --> G[Pod16: 192.168.2.31]
# eksctl로 활성화
kubectl set env daemonset aws-node -n kube-system ENABLE_PREFIX_DELEGATION=true

# 확인
kubectl get ds aws-node -n kube-system -o yaml | grep ENABLE_PREFIX_DELEGATION
4. 보안 그룹 관리
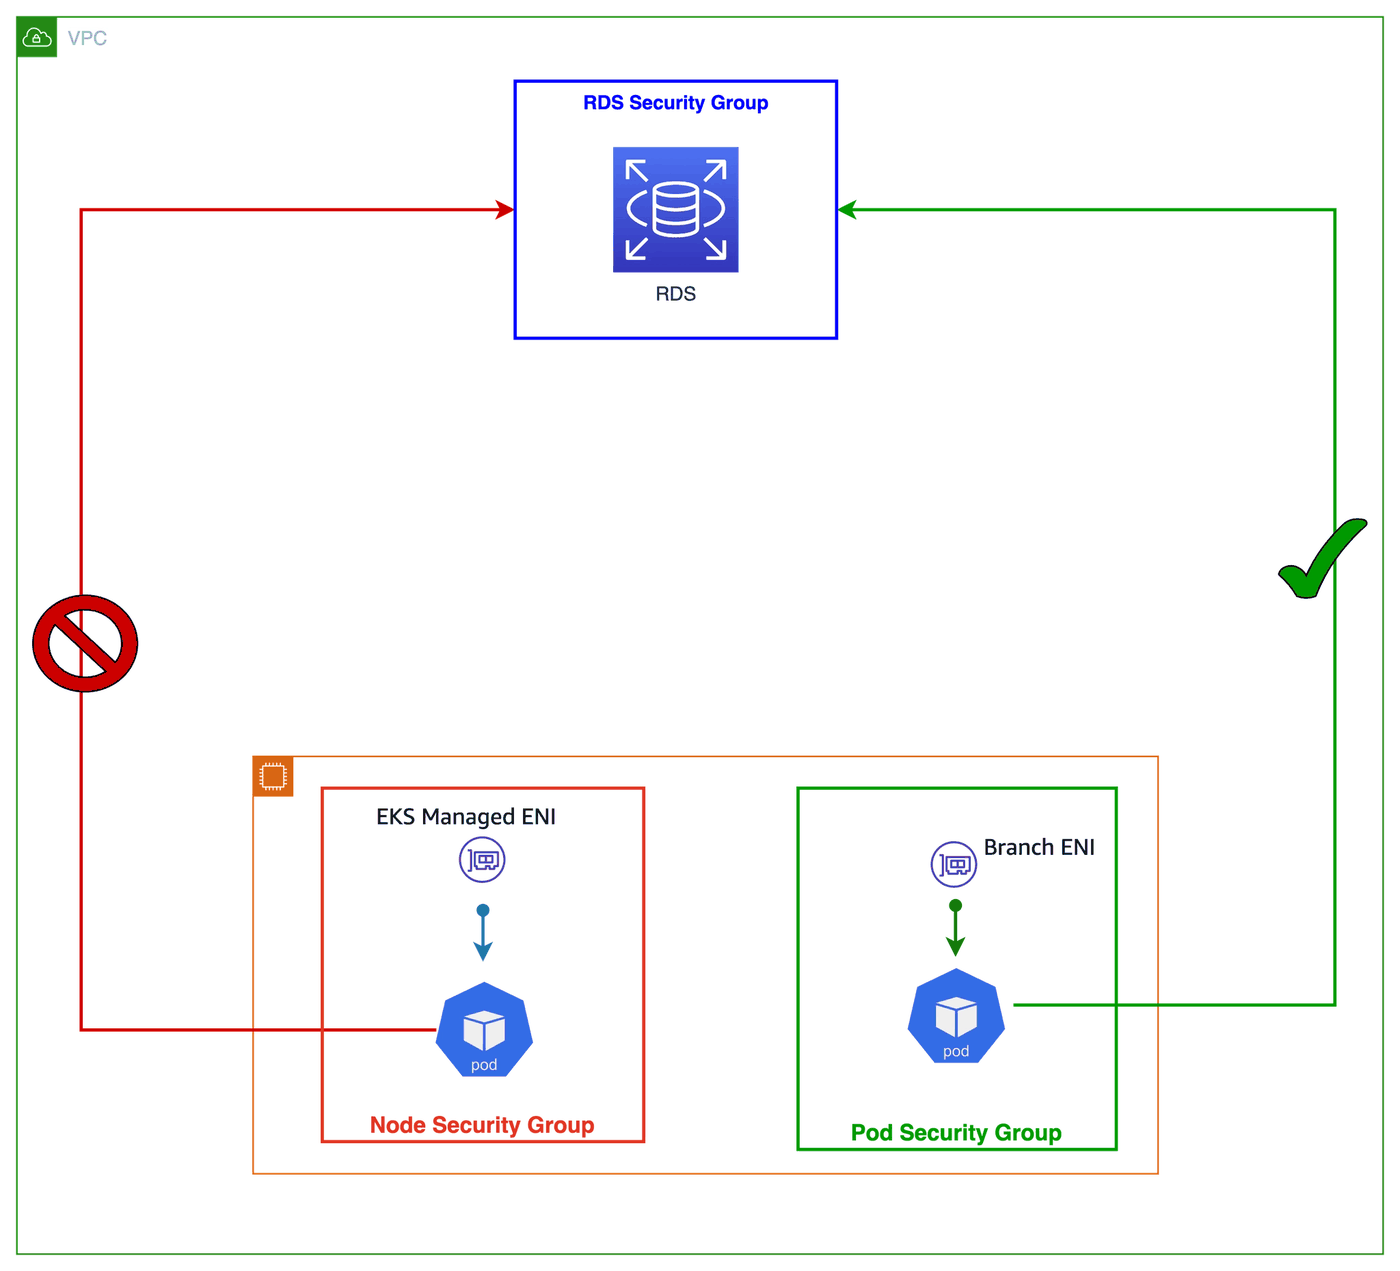
파드에 Branch ENI를 따로 붙이는 방식이라는 게 요점이다. 그 파드는 Node Security Group을 더 이상 상속하지 않으므로, 파드별 RDS 접근 제어가 쿠버네티스 정책이 아니라 ENI 수준에서 강제된다. 빨간 경로가 막히고 초록 경로만 통과하는 것이 그 결과다.
Pod 단위 보안 그룹 (Security Groups for Pods): - VPC CNI가 기본적으로 AWS VPC의 보안 그룹과 연동 - Pod별로 다른 보안 그룹 적용 가능 - Prefix Delegation 모드에서만 완벽하게 동작
graph TB
    A[RDS Security Group] -->|Allow| B[Pod Security Group]
    B --> C[Branch ENI]
    C --> D[Pod]

    E[EKS Managed ENI] -->|Node Security Group| F[Node]
apiVersion: v1
kind: Pod
metadata:
  name: my-pod
  annotations:
    vpc.amazonaws.com/security-groups: "sg-xxxxx"
spec:
  containers:
  - name: app
    image: nginx
노드에서 기본 네트워크 정보 확인
1. 노드 접속 및 IP 조회
# EC2 인스턴스 IP 조회
aws ec2 describe-instances --query "Reservations[*].Instances[*].[PublicIpAddress,PrivateIpAddress,InstanceName.Tags[?Key=='Name'].Value|[0]]" --output table

# 노드 정보 확인
kubectl get nodes -o custom-columns=NAME:.metadata.name,IP:.status.addresses[?(@.type=='InternalIP')].address,PODS:.status.capacity.pods

# 노드에 SSH 접속
ssh -i ~/.ssh/mykey.pem ec2-user@<NODE_IP>
2. 네트워크 인터페이스 확인
# 네트워크 인터페이스 목록
ip link show

# ENI 정보 확인
ip addr show

# 예시 출력
1: lo: <LOOPBACK,UP,LOWER_UP>
2: eth0@if3: <BROADCAST,MULTICAST,UP,LOWER_UP> (Primary ENI)
3: eni1@if4: <BROADCAST,MULTICAST,UP,LOWER_UP> (Secondary ENI)
eth0: Primary ENI (Node IP)
- eniY@ifX: Pod에 할당된 veth pair
# Pod IP 확인
kubectl get pod -o wide

# CNI log 확인
kubectl logs -n kube-system -l k8s-app=aws-node --tail=100
3. 라우팅 테이블 확인
# 라우팅 테이블 조회
ip route show

# 예시 출력
default via 192.168.1.1 dev eth0                     # 기본 게이트웨이
192.168.1.0/24 dev eth0 proto kernel scope link      # 노드 네트워크
192.168.1.64 dev eni1 scope link                     # Pod1 to ENI1
192.168.1.235 dev eni2 scope link                    # Pod2 to ENI2
노드 간 파드 통신
1. 파드 통신 흐름
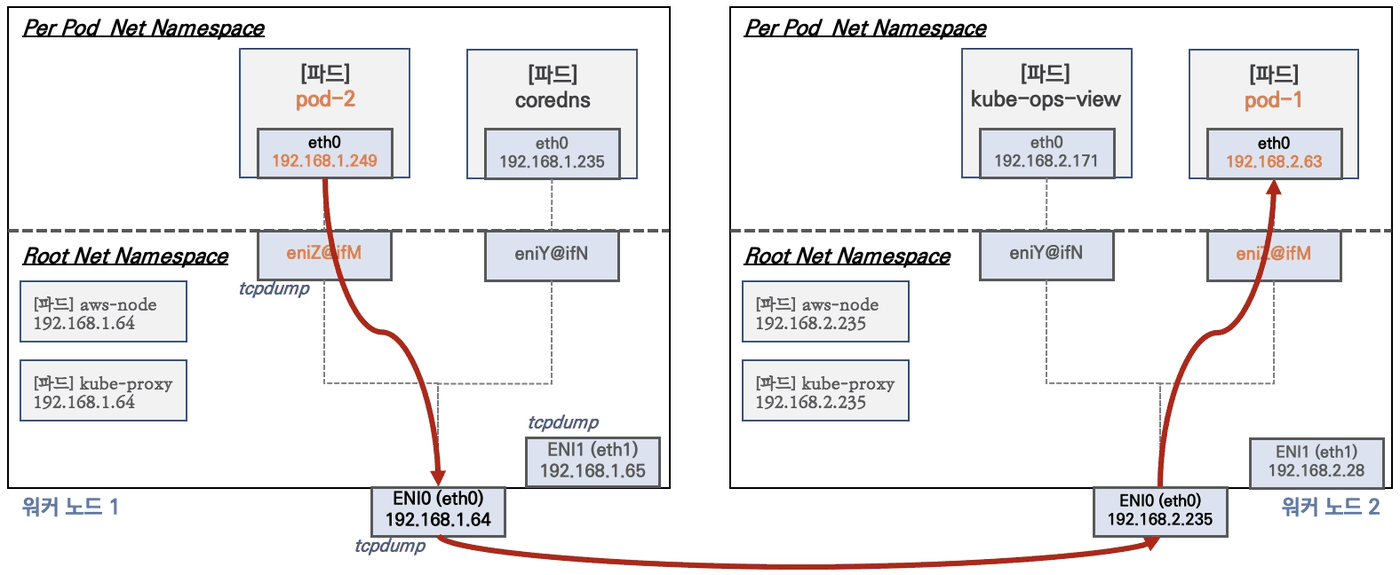
출발지 IP가 192.168.1.249로 끝까지 그대로 유지된다. 캡슐화 헤더도, 주소 재작성도 없다. 노드의 ENI0에서 tcpdump를 떠도 파드 IP가 그대로 보인다는 것이 VPC CNI에 오버레이가 없다는 실질적 증거다.
동일 노드 내 Pod 간 통신:
graph LR
    A[Pod1: 10.10.1.10] --> B[eth0 - veth pair]
    B --> C[Node Network Bridge]
    C --> D[eth0 - veth pair]
    D --> E[Pod2: 10.10.1.20]
sequenceDiagram
    participant P1 as Pod1 on Node1<br/>10.10.1.10
    participant N1 as Node1<br/>192.168.1.10
    participant VPC as VPC Routing
    participant N2 as Node2<br/>192.168.1.11
    participant P2 as Pod2 on Node2<br/>10.10.1.20

    P1->>N1: Packet to 10.10.1.20
    N1->>N1: Route lookup
    N1->>VPC: Forward to Node2 subnet
    VPC->>N2: Route to 10.10.1.20
    N2->>N2: Route lookup (to eniY)
    N2->>P2: Deliver packet

    P2-->>N2: Response
    N2-->>VPC: Forward to Node1 subnet
    VPC-->>N1: Route to 10.10.1.10
    N1-->>P1: Deliver response
2. Overlay Network vs AWS VPC CNI
Overlay Network (e.g., Calico, Flannel VXLAN)
graph TB
    subgraph "Calico CNI"
        subgraph "Node Network: 192.168.1.0/24"
            A[eth0: 192.168.1.1]
        end

        subgraph "Overlay Network: 10.1.1.0/24"
            B[Pod1: 10.1.1.1]
            C[Pod2: 10.1.1.2]
        end
    end

    A --> D[Virtual Router<br/>Outer Packet]
    D --> E[Pod Packet<br/>10.1.1.1 → 10.1.1.2]
AWS VPC CNI
graph TB
    subgraph "AWS VPC CNI"
        subgraph "Node Subnet: 192.168.1.0/24"
            A[eth0: 192.168.1.1]
            B[Pod1: 192.168.1.3]
            C[Pod2: 192.168.1.5]
        end
    end

    A --> D[Direct Routing]
    D --> B
    D --> C
3. NAT 동작 원리
Pod에서 외부로 통신 시 SNAT (Source NAT):
sequenceDiagram
    participant P as Pod<br/>192.168.1.64
    participant N as Node<br/>192.168.1.10
    participant I as Internet

    P->>N: Source: 192.168.1.64<br/>Dest: 8.8.8.8
    N->>N: SNAT Rule<br/>192.168.1.64 → 192.168.1.10
    N->>I: Source: 192.168.1.10<br/>Dest: 8.8.8.8

    I-->>N: Source: 8.8.8.8<br/>Dest: 192.168.1.10
    N-->>N: DNAT Rule<br/>192.168.1.10 → 192.168.1.64
    N-->>P: Source: 8.8.8.8<br/>Dest: 192.168.1.64
# NAT 테이블 확인
sudo iptables -t nat -S

# AWS-SNAT-CHAIN 규칙
-A AWS-SNAT-CHAIN-0 ! -d 192.168.0.0/16 -m comment --comment "AWS, SNAT" -j SNAT --to-source 192.168.1.10
파드에서 외부 통신
1. 외부 통신 흐름
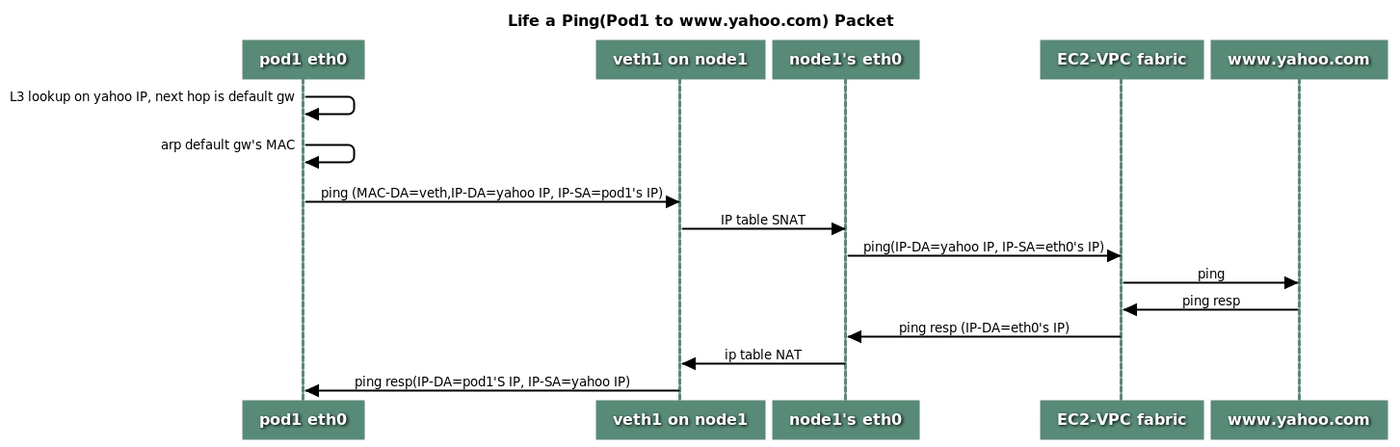
파드의 default gateway MAC이 브리지나 라우터가 아니라 veth 짝이라는 점, 그리고 SNAT이 veth1과 eth0 사이에서 일어난다는 점이 드러난다. 파드 네임스페이스를 빠져나가는 시점까지는 출발지가 여전히 파드 IP이고, 호스트 인터페이스에 이르러서야 노드 IP로 바뀐다.
Pod → Internet 통신 시:
graph LR
    A[Pod: 192.168.1.64] --> B[Node eth0<br/>192.168.1.10]
    B --> C[iptables SNAT]
    C --> D[VPC IGW]
    D --> E[Internet]
2. iptables SNAT 규칙
VPC CNI가 설정하는 iptables 규칙:
# 파드에서 외부로 나가는 모든 트래픽에 SNAT 적용
iptables -t nat -A AWS-SNAT-CHAIN-0 ! -d <VPC_CIDR> -j SNAT --to-source <NODE_IP>

# 예시
iptables -t nat -A AWS-SNAT-CHAIN-0 ! -d 192.168.0.0/16 -j SNAT --to-source 192.168.1.10
! -d 192.168.0.0/16: VPC CIDR 외부 트래픽만
- -j SNAT --to-source 192.168.1.10: Node IP로 변환
AWS VPC CNI 설정 변경
AWS VPC CNI는 여러 환경 변수로 동작을 제어할 수 있다.
1. WARM_ENI_TARGET
설명: 미리 준비할 ENI 개수
동작 방식: - 예약된 ENI를 미리 연결하여 Pod 생성 시 즉시 IP 할당 - Pod가 증가하면 ENI 개수 유지예시: - WARM_ENI_TARGET=1 → 항상 ENI 1개 여유 유지 - Pod 10개 → ENI 3개 (사용 2개 + 여유 1개)
2. WARM_IP_TARGET
설명: 미리 준비할 IP 주소 개수
동작 방식: - Secondary IP를 미리 할당하여 Pod 생성 속도 향상 - Pod 삭제 시에도 IP 유지 (재사용)주의사항: - WARM_ENI_TARGET과 함께 사용 불가 - IP 낭비 가능성 있음
3. MINIMUM_IP_TARGET
설명: 최소 유지할 IP 주소 개수
동작 방식: - 노드 시작 시 최소 IP 개수 확보 - Scale-out 시 빠른 Pod 생성 보장사용 시나리오: - 대규모 Pod 배포 예상 시 - Pod 생성 Latency 최소화 필요 시
노드에 파드 생성 갯수 제한
1. Secondary IP mode
최대 Pod 수 계산:
예시: m5.large (ENI 3개, IP 10개/ENI): 인스턴스별 최대 Pod 수:| Instance Type | ENI 개수 | IP/ENI | Max Pods (Secondary IP) |
|---|---|---|---|
| t3.small | 3 | 4 | 11 |
| t3.medium | 3 | 6 | 17 |
| t3.large | 3 | 12 | 35 |
| m5.large | 3 | 10 | 29 |
| m5.xlarge | 4 | 15 | 58 |
| p3dn.24xlarge | 15 | 50 | 737 |
2. Prefix Delegation mode
Prefix 모드는 ENI 하나(ENI0)만으로 파드 110개에 도달하는 반면, 보조 IP 방식은 15개를 위해 ENI 3개를 쓴다. 제약이 ENI 부착 한도에서 서브넷의 /28 블록 확보 가능성으로 옮겨간다.
최대 Pod 수 계산:
예시: m5.large (ENI 3개, Prefix 10개/ENI): Prefix Delegation 활성화:# Prefix Delegation 모드 활성화
kubectl set env daemonset aws-node -n kube-system ENABLE_PREFIX_DELEGATION=true
# 확인
kubectl get ds aws-node -n kube-system -o yaml | grep ENABLE_PREFIX_DELEGATION
3. maxPods 계산 방법
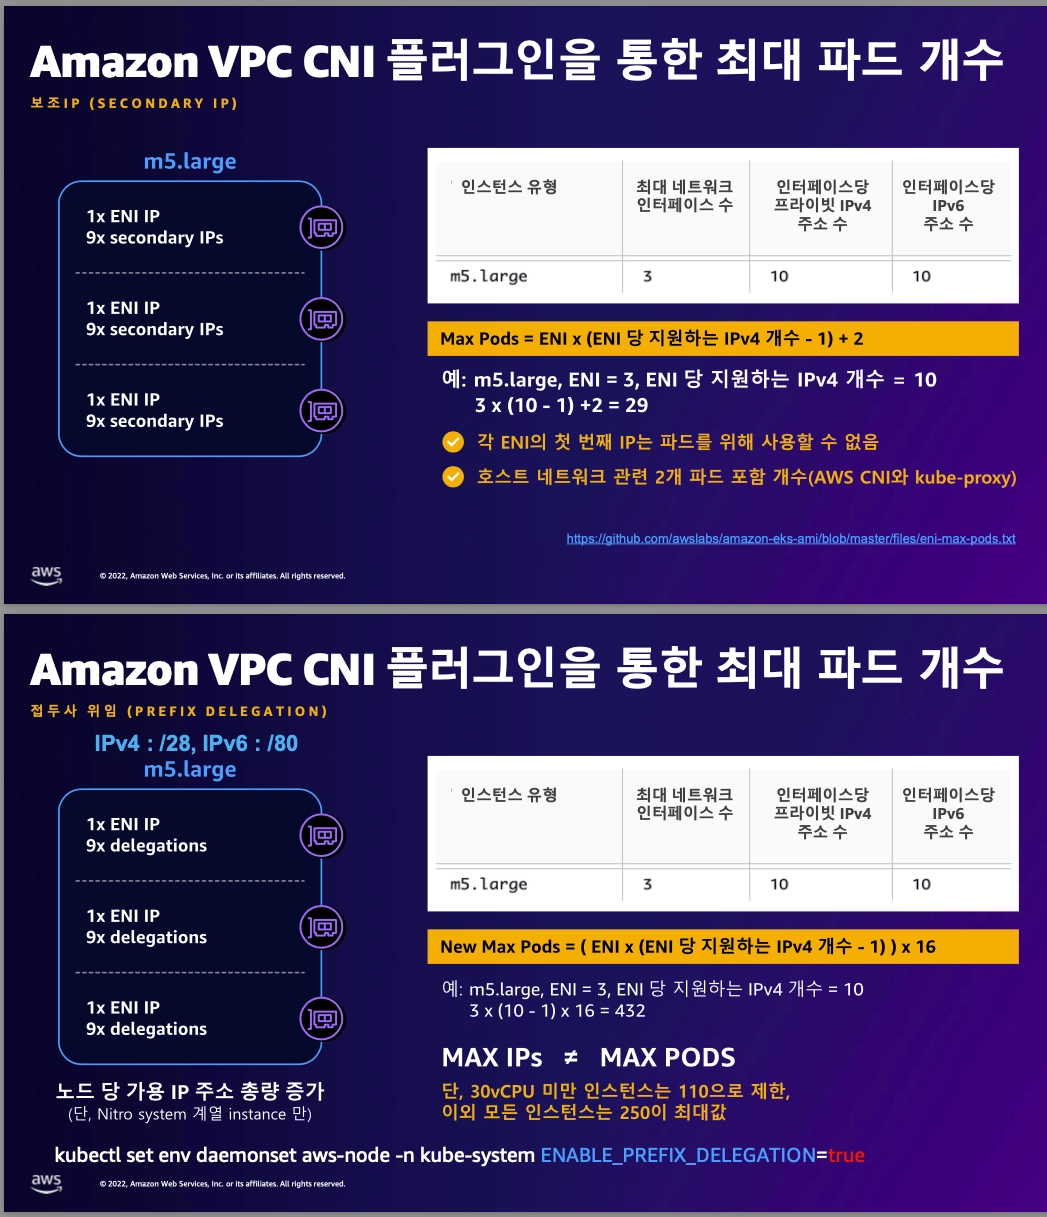
공식의 +2는 aws-node와 kube-proxy가 호스트 네트워크를 쓰기 때문에 붙는다. 그리고 Prefix 위임으로 계산상 432개가 나와도 30vCPU 미만 인스턴스는 110개로 잘린다 — IP 산술과 실제 maxPods가 갈라지는 지점이다.
kubelet의 maxPods 제한 확인:
# kubelet 설정 확인
kubectl get node <NODE_NAME> -o json | jq .status.capacity.pods

# 또는
kubectl describe node <NODE_NAME> | grep pods
# 기본 maxPods 변경
cat <<EOF | sudo tee /etc/kubernetes/kubelet/kubelet-config.json
{
  "maxPods": 50
}
EOF

# kubelet 재시작
sudo systemctl restart kubelet
Kubernetes Service
1. Service 개념
Service는 Pod 간 통신 시 고정된 IP 와 도메인 이름
문제점: - Pod IP는 재시작 시 변경됨 - 여러 Pod에 로드밸런싱 필요
해결책: - Service가 고정 IP (ClusterIP) 제공 - Endpoint를 통해 Pod 목록 관리 - 레이블 Selector로 Pod 자동 등록
graph TB
    A[Client] --> B[Service<br/>10.200.1.1]

    subgraph "Endpoints"
        B --> C[Pod1: 172.16.1.1]
        B --> D[Pod2: 172.16.1.2]
        B --> E[Pod3: 172.16.1.3]
    end
2. Service 종류
Kubernetes에는 총 4가지 Service 종류가 있다.
| Service 종류 | 접근 범위 | 용도 |
|---|---|---|
| ClusterIP | 클러스터 내부 | 기본 Service, 내부 통신만 |
| NodePort | 외부 클라이언트 | 노드 IP:NodePort로 접근 |
| LoadBalancer | 외부 클라이언트 (로드밸런서) | AWS ELB 등 외부 LB 연동 |
| ExternalName | 외부 서비스 | 외부 도메인 CNAME 매핑 |
3. ClusterIP Service
기본 Service 타입으로 클러스터 내부에서만 접근 가능한다.
apiVersion: v1
kind: Service
metadata:
  name: my-service
spec:
  type: ClusterIP
  selector:
    app: MyApp
  ports:
  - protocol: TCP
    port: 10200        # Service Port
    targetPort: 8080   # Pod Port
sequenceDiagram
    participant C as Client Pod
    participant S as Service<br/>10.200.1.1
    participant K as kube-proxy
    participant P1 as Pod1<br/>172.16.1.1:8080
    participant P2 as Pod2<br/>172.16.1.2:8080

    C->>S: Request to 10.200.1.1:10200
    S->>K: iptables rule lookup
    K->>K: Random Pod selection
    K->>P1: Forward to 172.16.1.1:8080
    P1-->>C: Response
4. NodePort Service
NodePort는 모든 노드의 IP:NodePort로 외부에서 접근 가능한다.
apiVersion: v1
kind: Service
metadata:
  name: my-nodeport
spec:
  type: NodePort
  selector:
    app: MyApp
  ports:
  - protocol: TCP
    port: 10200
    targetPort: 8080
    nodePort: 30100   # 30000-32767 범위
graph LR
    A[External Client] -->|NodeIP:30100| B[Node1<br/>192.168.1.10]
    A -->|NodeIP:30100| C[Node2<br/>192.168.1.11]

    B --> D[kube-proxy]
    C --> D

    D --> E[Pod1]
    D --> F[Pod2]
    D --> G[Pod3]
<NodeIP>:<NodePort>로 접근
- 모든 노드에서 동일한 NodePort 사용
- 프로덕션에서는 LoadBalancer 사용 권장
5. LoadBalancer Service
LoadBalancer는 클라우드 제공업체의 외부 로드밸런서를 생성한다.
apiVersion: v1
kind: Service
metadata:
  name: my-loadbalancer
spec:
  type: LoadBalancer
  selector:
    app: MyApp
  ports:
  - protocol: TCP
    port: 80
    targetPort: 8080
graph TB
    A[Internet] --> B[AWS ELB<br/>a1b2c3.elb.amazonaws.com]

    B --> C[Node1:NodePort]
    B --> D[Node2:NodePort]
    B --> E[Node3:NodePort]

    C --> F[kube-proxy]
    D --> F
    E --> F

    F --> G[Pod1]
    F --> H[Pod2]
    F --> I[Pod3]
6. ExternalName Service
ExternalName은 외부 서비스의 도메인 이름을 매핑한다.
apiVersion: v1
kind: Service
metadata:
  name: my-database
spec:
  type: ExternalName
  externalName: mydb.example.com
kube-proxy 모드
kube-proxy는 Service를 구현하는 핵심 컴포넌트로, 여러 모드를 지원한다.
1. User Space 모드
가장 초기 모드로 kube-proxy가 직접 프록시 역할을 한다.
graph TB
    A[Client] --> B[iptables<br/>REDIRECT]
    B --> C[kube-proxy<br/>User Space]
    C --> D[Pod1]
    C --> E[Pod2]
2. iptables 모드
기본 모드로 iptables 규칙으로 트래픽을 전달한다.
graph TB
    A[Client] --> B[iptables<br/>DNAT]
    B --> C[Pod1]
    B --> D[Pod2]
    B --> E[Pod3]
장점: - Kernel Space에서 처리 (빠름) - 안정적
단점: - iptables 규칙 수가 많아지면 성능 저하 - 수천 개 Service 시 Latency 증가
3. IPVS 모드
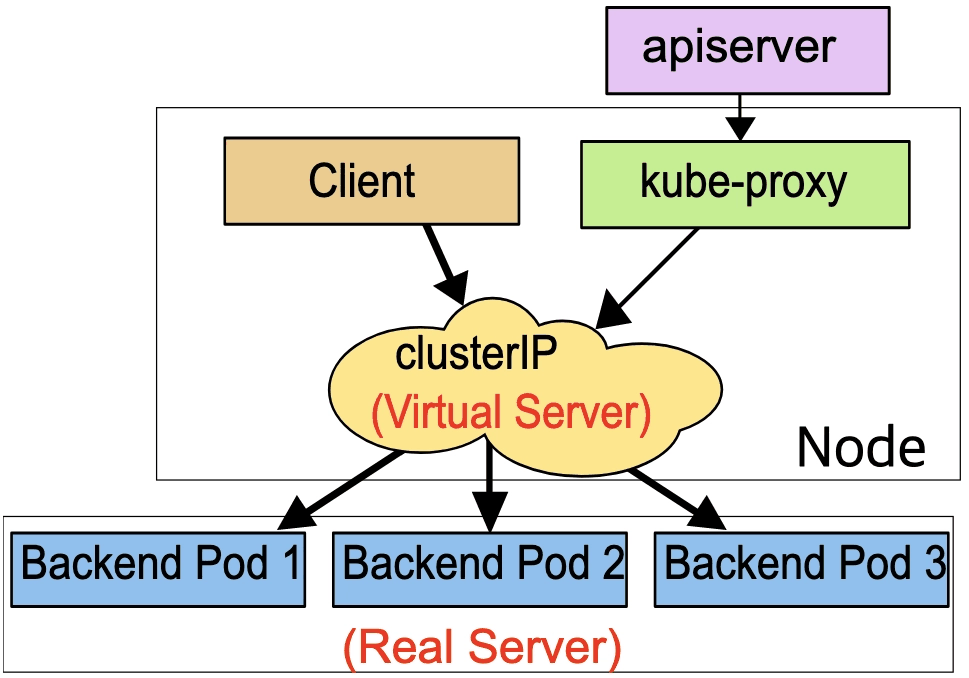
IPVS는 쿠버네티스 오브젝트를 고전적인 LVS 용어에 얹는다. ClusterIP가 Virtual Server이고 각 파드가 Real Server다. iptables 모드가 제공하지 못하는 rr·lc·sh 같은 실제 로드밸런싱 알고리즘을 IPVS 모드에서 쓸 수 있는 이유가 이 대응 관계에 있다.
IPVS(IP Virtual Server)는 Linux Kernel의 Layer 4 로드밸런서이다.
graph TB
    A[Client] --> B[IPVS<br/>Hash Table]
    B --> C[Pod1]
    B --> D[Pod2]
    B --> E[Pod3]
활성화 방법:
# kube-proxy ConfigMap 수정
kubectl edit cm kube-proxy -n kube-system

# mode: ipvs 설정
data:
  config.conf: |
    mode: "ipvs"

# kube-proxy 재시작
kubectl delete pod -n kube-system -l k8s-app=kube-proxy
단점: - IPVS 커널 모듈 필요 - 설정 복잡
4. nftables 모드
nftables는 iptables의 후속 기술이다.
특징: - Linux Kernel 5.13 이상 필요 - iptables보다 성능 개선 - Kubernetes 1.31부터 지원 시작
5. eBPF/XDP 모드
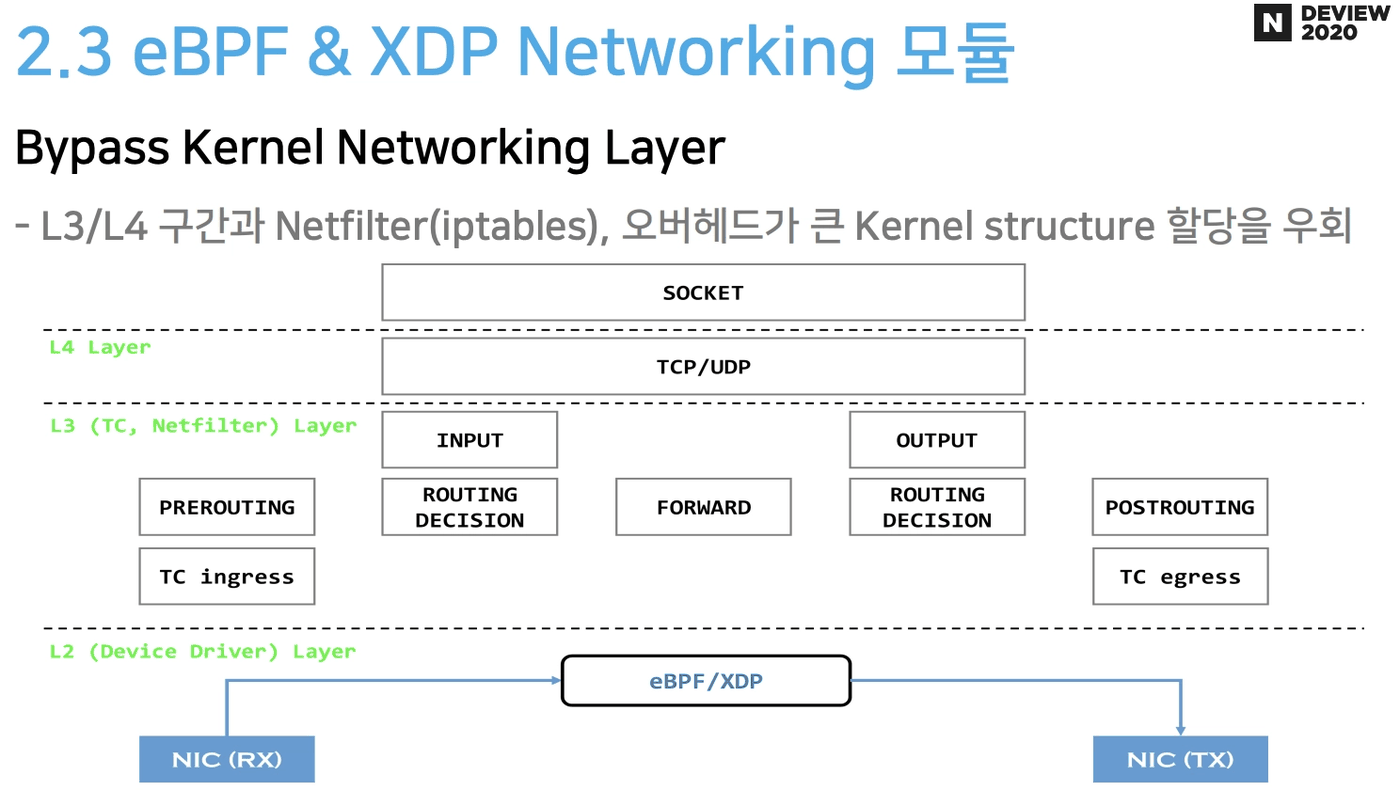
XDP는 L2 디바이스 드라이버 계층, TC ingress보다 아래에서 후킹한다. netfilter 체인 전체와 skb 할당을 건너뛴다는 뜻이며, 흔히 함께 묶여 언급되는 TC 기반 eBPF 프로그램보다 엄밀히 더 낮은 지점이다.
eBPF(Extended Berkeley Packet Filter)는 Kernel Networking Layer를 우회한다.
graph TB
    subgraph "Kernel Space"
        A[Socket Layer]
        B[TCP/UDP Layer]
        C[IP Layer]
        D[Device Driver<br/>NIC RX]

        A --> B
        B --> C
        C --> D
    end

    E[eBPF/XDP] --> D
    E --> F[Pod]
특징: - 극한의 성능: L3/L4 구간 우회 - Cilium CNI 등에서 사용 - Kernel 프로그래밍 필요
AWS LoadBalancer Controller
AWS Load Balancer Controller는 Kubernetes Service를 AWS NLB/ALB와 연동한다.
1. Instance mode vs IP mode
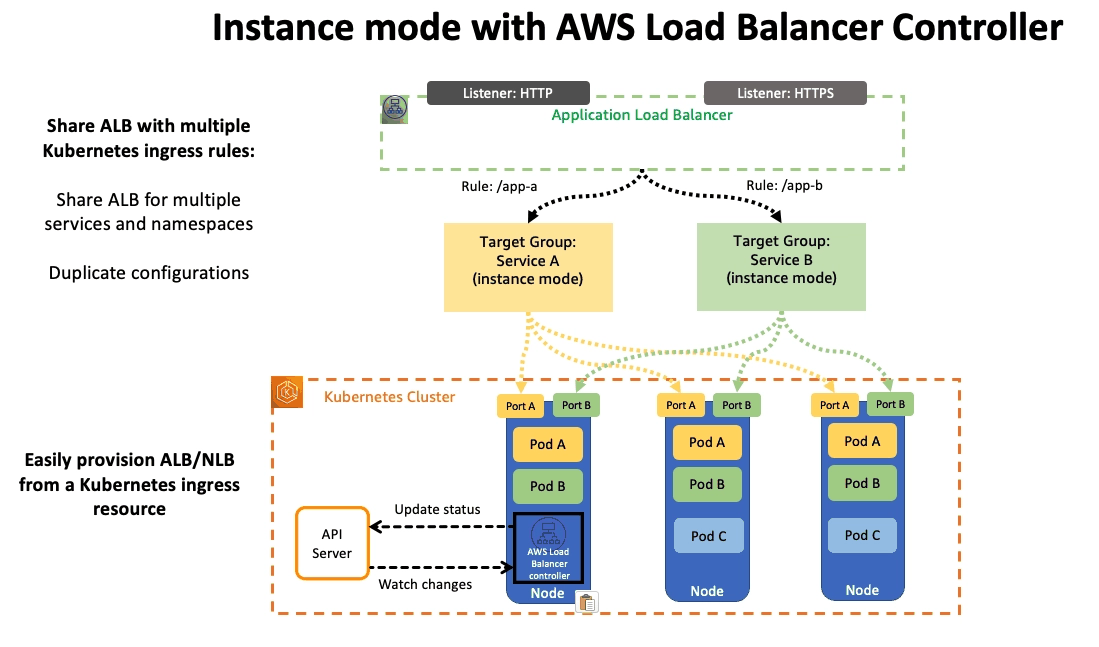
Instance mode는 타깃 그룹에 모든 노드의 NodePort를 등록한다. 파드가 실제로 어디 떠 있는지와 무관하므로, 해당 파드가 없는 노드로 트래픽이 떨어져 kube-proxy 홉을 한 번 더 타는 일이 생긴다.
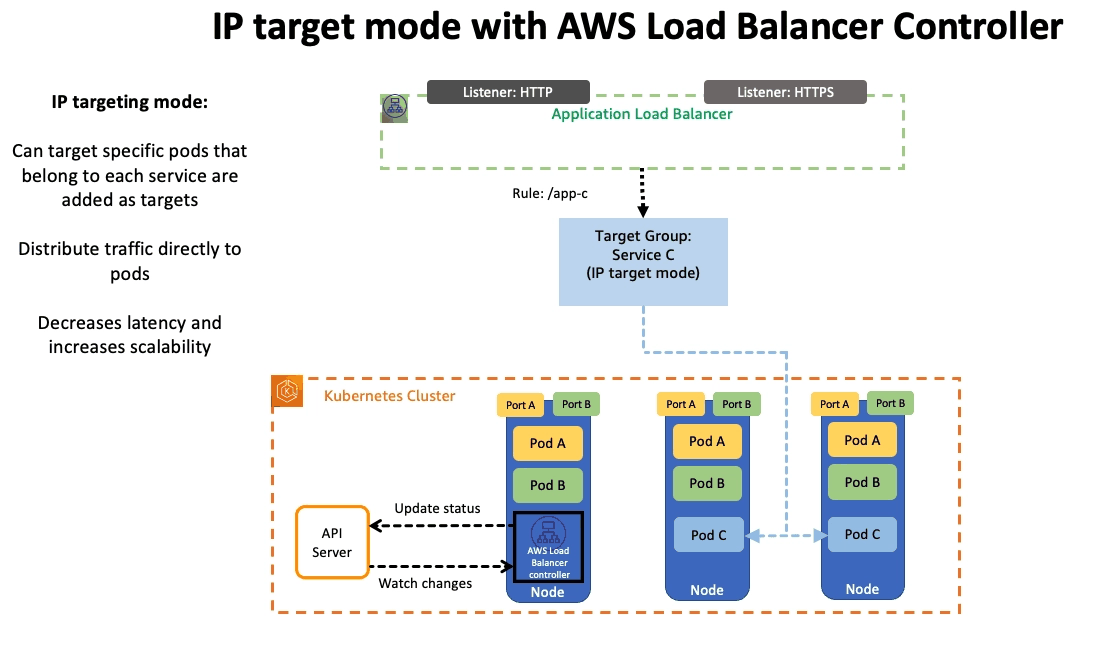
반면 IP mode의 타깃 그룹에는 Pod C가 실제로 떠 있는 node 2·3만 들어가고 node 1은 아예 없다. 타깃 수가 노드 수가 아니라 파드 레플리카 수를 따라간다는 뜻이고, 그러려면 파드 IP가 ALB에서 라우팅 가능해야 하므로 오버레이가 아닌 VPC CNI가 전제된다.
(1) Instance mode
특징: - NodePort 사용 - ELB → NodeIP:NodePort → kube-proxy → Pod - externalTrafficPolicy: Cluster (기본값)
graph TB
    A[Client] --> B[AWS NLB]

    B --> C[Node1:31245]
    B --> D[Node2:31245]

    C --> E[iptables]
    D --> E

    E --> F[Pod A on Node1]
    E --> G[Pod B on Node1]
    E --> H[Pod C on Node2]
단점: - 2 hop (Node → Pod) - 소스 IP 보존 안 됨
(2) IP mode
특징: - Pod IP 직접 타겟 등록 - ELB → Pod IP 직접 통신 - externalTrafficPolicy: Local 권장
graph TB
    A[Client] --> B[AWS NLB<br/>IP Target Mode]

    B --> C[Pod A: 192.168.1.10]
    B --> D[Pod B: 192.168.1.20]
    B --> E[Pod C: 192.168.1.30]
단점: - Proxy Protocol v2 필요 (NLB만) - 복잡한 설정
2. IRSA 설정
AWS Load Balancer Controller는 IRSA (IAM Roles for Service Accounts)를 사용한다.
# (1) IAM OIDC Provider 생성
eksctl utils associate-iam-oidc-provider --cluster myeks --approve

# (2) IAM Policy 다운로드
curl -o iam_policy.json https://raw.githubusercontent.com/kubernetes-sigs/aws-load-balancer-controller/refs/heads/main/docs/install/iam_policy.json

# (3) IAM Policy 생성
aws iam create-policy \
  --policy-name AWSLoadBalancerControllerIAMPolicy \
  --policy-document file://iam_policy.json

# (4) Service Account 생성
eksctl create iamserviceaccount \
  --cluster=myeks \
  --namespace=kube-system \
  --name=aws-load-balancer-controller \
  --attach-policy-arn=arn:aws:iam::$ACCOUNT_ID:policy/AWSLoadBalancerControllerIAMPolicy \
  --override-existing-serviceaccounts \
  --approve

# (5) Service Account 확인
kubectl get sa aws-load-balancer-controller -n kube-system -o yaml
3. NLB 배포
Helm으로 AWS Load Balancer Controller 설치:
# Helm repo 추가
helm repo add eks https://aws.github.io/eks-charts
helm repo update

# 설치
helm install aws-load-balancer-controller eks/aws-load-balancer-controller \
  -n kube-system \
  --set clusterName=myeks \
  --set serviceAccount.create=false \
  --set serviceAccount.name=aws-load-balancer-controller \
  --set region=ap-northeast-2 \
  --set vpcId=vpc-xxxxxxxx

# 확인
kubectl get deploy -n kube-system aws-load-balancer-controller
apiVersion: v1
kind: Service
metadata:
  name: echo-service-nlb
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-type: "nlb"
    service.beta.kubernetes.io/aws-load-balancer-scheme: "internet-facing"
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: "ip"
spec:
  type: LoadBalancer
  selector:
    app: echo
  ports:
  - port: 80
    targetPort: 8080
# Service 확인
kubectl get svc echo-service-nlb

# NLB DNS 확인
NLB_DNS=$(kubectl get svc echo-service-nlb -o jsonpath='{.status.loadBalancer.ingress[0].hostname}')
curl http://$NLB_DNS
Ingress (L7 HTTP)
1. Ingress Controller
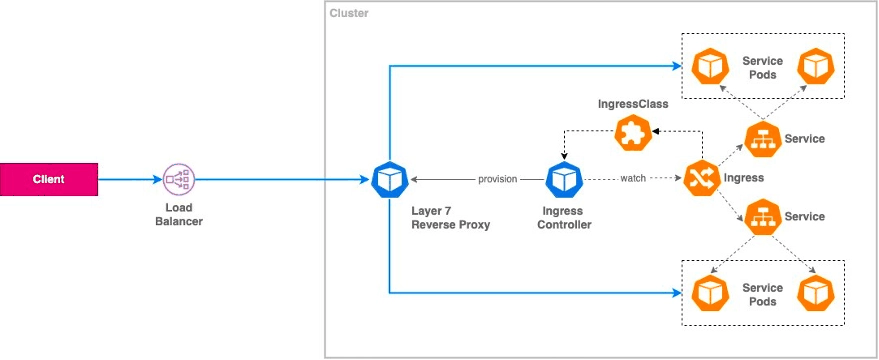
제어 경로와 데이터 경로가 분리돼 있다. Ingress Controller는 점선으로 표시된 watch/provision만 담당하고, 실제 요청 트래픽(파란 화살표)은 L7 리버스 프록시에서 파드로 곧장 흐른다. 컨트롤러가 죽어도 이미 뜬 트래픽은 끊기지 않는 구조다.
Ingress Controller는 L7 HTTP/HTTPS 로드밸런싱을 제공한다.
graph TB
    A[Client] --> B[ALB<br/>*.elb.amazonaws.com]

    B -->|/api| C[API Service]
    B -->|/web| D[Web Service]

    C --> E[API Pod 1]
    C --> F[API Pod 2]

    D --> G[Web Pod 1]
    D --> H[Web Pod 2]
2. ALB Ingress Controller
AWS Load Balancer Controller를 사용하여 ALB를 생성한다.
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-ingress
  annotations:
    alb.ingress.kubernetes.io/scheme: internet-facing
    alb.ingress.kubernetes.io/target-type: ip
    alb.ingress.kubernetes.io/listen-ports: '[{"HTTP": 80}, {"HTTPS": 443}]'
    alb.ingress.kubernetes.io/certificate-arn: arn:aws:acm:...
spec:
  ingressClassName: alb
  rules:
  - host: api.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: api-service
            port:
              number: 8080
  - host: web.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: web-service
            port:
              number: 80
sequenceDiagram
    participant C as Client
    participant A as ALB
    participant I as Ingress Controller
    participant S as Service
    participant P as Pod

    C->>A: GET api.example.com/users
    A->>A: Host-based routing
    A->>S: Forward to api-service
    S->>P: kube-proxy routing
    P-->>S: Response
    S-->>A: Response
    A-->>C: Response
ExternalDNS
1. ExternalDNS
ExternalDNS는 Kubernetes Service/Ingress를 Route53에 자동 등록한다.
graph LR
    A[Ingress/Service] --> B[ExternalDNS]
    B --> C[Route53]

    C --> D[DNS Record<br/>api.example.com]
    C --> E[DNS Record<br/>web.example.com]
2. ExternalDNS 설정
Helm으로 설치:
# Helm repo 추가
helm repo add bitnami https://charts.bitnami.com/bitnami
helm repo update

# 설치
helm install external-dns bitnami/external-dns \
  --set provider=aws \
  --set aws.region=ap-northeast-2 \
  --set txtOwnerId=myeks \
  --set domainFilters[0]=example.com \
  --set policy=sync

# 확인
kubectl get deploy external-dns
apiVersion: v1
kind: Service
metadata:
  name: my-service
  annotations:
    external-dns.alpha.kubernetes.io/hostname: api.example.com
spec:
  type: LoadBalancer
  selector:
    app: api
  ports:
  - port: 80
# Route53 레코드 조회
aws route53 list-resource-record-sets --hosted-zone-id <ZONE_ID> --query "ResourceRecordSets[?Name=='api.example.com.']"
핵심 개념 정리
1. VPC CNI vs Overlay CNI
| 항목 | VPC CNI | Overlay CNI (Calico, Flannel) |
|---|---|---|
| Pod IP | VPC CIDR 내부 | VPC 외부 대역 (10.x.x.x) |
| Encapsulation | 없음 | VXLAN, IP-in-IP |
| 성능 | 높음 (직접 라우팅) | 낮음 (Overhead) |
| AWS 통합 | Security Group, NACLs 지원 | 지원 안 함 |
| 라우팅 | VPC Route Table | Overlay Route Table |
| IP 제약 | VPC CIDR 크기 제한 | 제약 없음 |
2. Secondary IP vs Prefix Delegation
| 항목 | Secondary IP mode | Prefix Delegation mode |
|---|---|---|
| IP 할당 단위 | 개별 IP | /28 Prefix (16개) |
| Max Pods (m5.large) | 29개 | 434개 |
| IP 효율성 | 낮음 | 높음 |
| 스케일 속도 | 느림 | 빠름 |
| Subnet 크기 | /16 이상 권장 | /28 이상 권장 |
언제 Prefix Delegation을 사용해야 하나? - 노드당 많은 Pod 필요 (30개 이상) - IP 주소 절약 필요 - 빠른 Pod 생성 속도 필요
3. kube-proxy 모드 비교
| 모드 | 성능 | 확장성 | 복잡도 | Kernel 요구사항 |
|---|---|---|---|---|
| userspace | - | |||
| iptables | iptables | |||
| IPVS | IPVS 모듈 | |||
| nftables | nftables (5.13+) | |||
| eBPF/XDP | eBPF (4.8+) |
권장사항: - 소규모 클러스터 (< 100 Service): iptables - 대규모 클러스터 (> 1000 Service): IPVS - 극한 성능 필요: eBPF/XDP (Cilium)
4. Service 종류 비교
graph TB
    subgraph "Service Types"
        A[ClusterIP<br/>Internal Only]
        B[NodePort<br/>NodeIP:Port]
        C[LoadBalancer<br/>External LB]
        D[ExternalName<br/>CNAME]
    end

    E[Internal Clients] --> A

    F[External Clients] --> B
    F --> C

    A --> G[Pods]
    B --> G
    C --> G

    D --> H[External Service<br/>db.example.com]
마지막 업데이트: 2026-03-24